支持向量机(SVM)+SMO算法讲解
支持向量机(SVM)+SMO算法讲解
关于模式识别学习,我自己认为就是边看代码边学习比较好,因为只看概念很容易造成误解,认为自己都懂了,其实还很浅显,要想深入理解,还是必须结合代码。
先推荐一篇很不错的博客吧,浏览量快100万了,讲的也很清楚
文中所需的数据我会放到资源中,以供大家学习。
这是我对这个程序的笔记,一家之言,姑且看之
def testDigits(kTup=('rbf', 10)):
    dataArr,labelArr = loadImages(r'C:\Users\Administrator\Desktop\MLiA_SourceCode\Ch06\digits\trainingDigits')
    b,alphas = smoP(dataArr, labelArr, 200, 0.0001, 10000,kTup)#加速版smo,训练时间短,正确率高
    # b,alphas = smoSimple(dataArr, labelArr, 200, 0.0001, 20)      #简化版smo,训练时间长,正确率不高
    # b,alphas = smoPK(dataArr, labelArr, 200, 0.0001, 10000)  #不用核函数的计算,与加速版的SMO算法区别仅在于不同的误差计算方法,即一个用了核函数,一个没用
    datMat=mat(dataArr); labelMat = mat(labelArr).transpose()  #dataArr,labelArr  402*1024  1*402
    svInd=nonzero(alphas>0)[0]
    # print(nonzero(alphas))
    # print(type(svInd))
    sVs=datMat[svInd] #支持向量
    labelSV = labelMat[svInd];
    print ("there are %d Support Vectors" % shape(sVs)[0])
    m,n = shape(datMat)#402*1024
    errorCount = 0
    for i in range(m):
        kernelEval = kernelTrans(sVs,datMat[i,:],kTup)
        predict=kernelEval.T * multiply(labelSV,alphas[svInd]) + b
        if sign(predict)!=(labelArr[i]):   #sign()的用法:大于0的返回1 # sign(2) = 1  小于0的返回-1 # sign(-3) = -1等于0的返回0 # sign(0) = 0
        	errorCount += 1
    print ("the training error rate is: %f" % (float(errorCount)/m))
    dataArr,labelArr = loadImages(r'C:\Users\Administrator\Desktop\MLiA_SourceCode\Ch06\digits\testDigits')
    errorCount = 0
    datMat=mat(dataArr); labelMat = mat(labelArr).transpose()
    m,n = shape(datMat)
    for i in range(m):
        kernelEval = kernelTrans(sVs,datMat[i,:],kTup)
        predict=kernelEval.T * multiply(labelSV,alphas[svInd]) + b
        if sign(predict)!=sign(labelArr[i]):
        	errorCount += 1
    print ("the test error rate is: %f" % (float(errorCount)/m))
先看这段代码吧!
定义函数名虽然叫做测试testDigits,但是里面包含了训练过程。
第一个函数
loadImages(self)self表示的是文件的路径,loadImages(self)也是自己定义的一个函数,便于读取文件。具体函数如下:
def loadImages(dirName):
    from os import listdir
    hwLabels = []
    trainingFileList = listdir(dirName)           #load the training set
    m = len(trainingFileList)
    trainingMat = zeros((m,1024))#m=402
    # print(m)
    for i in range(m):
        fileNameStr = trainingFileList[i]
        # print(fileNameStr)
        fileStr = fileNameStr.split('.')[0]     #take off .txt
        classNumStr = int(fileStr.split('_')[0])
        if classNumStr == 9:
        	hwLabels.append(-1)
        else:
        	hwLabels.append(1)
        trainingMat[i,:] = img2vector('%s/%s' % (dirName, fileNameStr))
    # print(hwLabels)
    return trainingMat, hwLabels     # trainingMat  402*1024
接下来先把这个代码块讲完,再讲第一个代码块。from os import listdir,就是引用库,读取文件的列表,trainingFileList = listdir(dirName)就是读取传过来的路径里面的文件名字列表。读取出来如下,文件夹里面也如下。看到了不,读取文件名字之后放进一个列表中,便于后边使用。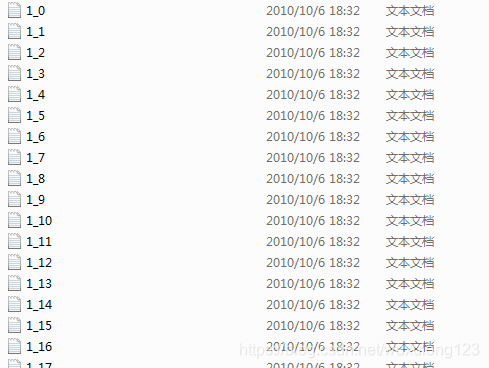
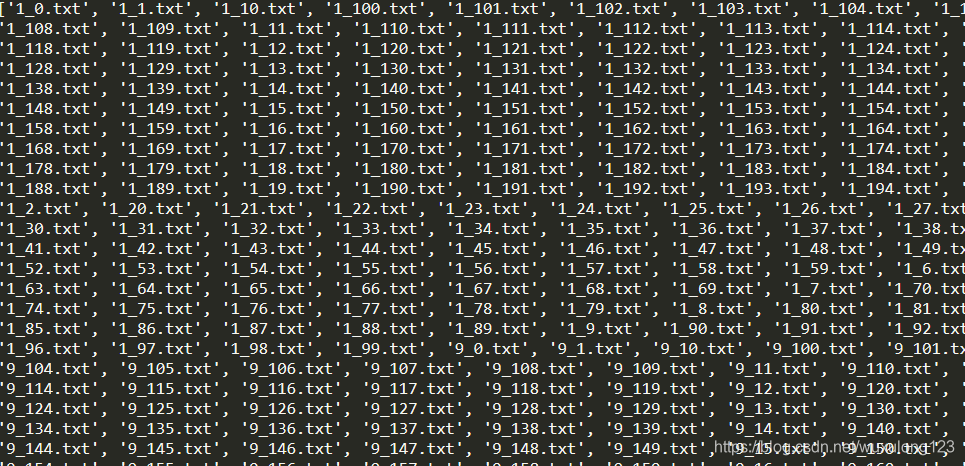
fileStr = fileNameStr.split(’.’)[0],这个函数就是以.为分割,分成两个元素,[“1_0”,“txt”],然后去第一个元素,就是1_0,这个函数呢?classNumStr = int(fileStr.split(’_’)[0]),不用我说你也应该知道了,就是取1,并化为整型。
if classNumStr == 9:
hwLabels.append(-1)
else:
hwLabels.append(1)
上面这个呢?就是把9标记为-1,1标记为1.这里不论把谁标记为1和-1都可以,后边会解释。但是标记也不必都是1和-1,其他也可以,但是为了方便计算,这样标记最好,前人的经验,不需要知道为什么都行,就像我们知道1+1=2,但是谁能知道为什么呢?恐怕只有顶尖的数学家才能解释一二。简而言之,记住就好。
trainingMat[i,:] = img2vector(’%s/%s’ % (dirName, fileNameStr))
上面这个呢?就是把1_0.txt里面的数据(原来是3232)转化为11024,为什么呢?因为好计算啊,一行就完了,不用再计算时一行一行的去循取出来计算,就是便于存取。这里涉及自己定义的一个函数 img2vector(self)这里的self就是C:\Users\Administrator\Desktop\MLiA_SourceCode\Ch06\digits\trainingDigits\1_0.txt,下面介绍img2vector(self)函数:
def img2vector(filename):
    returnVect = zeros((1,1024))
    fr = open(filename)
    for i in range(32):
        lineStr = fr.readline()
        for j in range(32):
            returnVect[0,32*i+j] = int(lineStr[j])
    return returnVect
returnVect = zeros((1,1024))这是矩阵定义就不说了吧?
fr=open(filename)就是打开刚才的路径,文件,读取里面的数据,不知道里面啥数据的可以去看看文章开头的资源。
for i in range(32):
lineStr = fr.readline()
for j in range(32):
returnVect[0,32i+j] = int(lineStr[j])
上面的程序就是把文件中(3232)的矩阵一行一行的读取出来然后整合成1*1024形式。
接下来,继续讲解第一个代码块
b,alphas = smoP(dataArr, labelArr, 200, 0.0001, 10000,kTup)这里就要涉及SVM了,b和alpha都是SVM的重要参数,也是待学习参数。smoP就是SMO算法,smoP函数如下:
它的主要目的就是根据条件,学习修正参数。
def smoP(dataMatIn, classLabels, C, toler, maxIter,ktup):    #full Platt SMO
    oS = optStruct(mat(dataMatIn),mat(classLabels).transpose(),C,toler, ktup)
    # print(oS.K.shape)402*402
    # for i in range(402):    K的对角线元素全为1
    # 	print(oS.K.A[i][i])
    iter = 0
    entireSet = True; alphaPairsChanged = 0
    while (iter < maxIter) and(   (alphaPairsChanged > 0) or(entireSet)  ):#一直执行这个循环,直到循环10000次或者alpha不再改变
        alphaPairsChanged = 0
        if entireSet:   #go over all
            # print(3213213333333333333333333333333333)
            for i in range(oS.m): #oS.m=402
                alphaPairsChanged += innerL(i,oS,iter)
                print ("fullSet, iter: %d i:%d, pairs changed %d" % (iter,i,alphaPairsChanged))
            iter += 1
        else:#go over non-bound (railed) alphas
            nonBoundIs = nonzero((oS.alphas.A > 0) * (oS.alphas.A < C))[0]#找到alpha中同时满足大于0小于c的数,[0]表示返回索引值
            for i in nonBoundIs:
                alphaPairsChanged += innerL(i,oS,iter)
                print ("non-bound, iter: %d i:%d, pairs changed %d" % (iter,i,alphaPairsChanged))
            iter += 1
        #下面这句自己加的,可以在训练达到最好时及时停止。因为上面的程序在偶数时不会停止
        if alphaPairsChanged==0:
        	maxIter=iter

        if entireSet:
            entireSet = False #toggle entire set loop
        elif (alphaPairsChanged == 0):
            entireSet = True
        print ("iteration number: %d" % iter)
    return oS.b,oS.alphas
smoP的算法中第二行
oS = optStruct(mat(dataMatIn),mat(classLabels).transpose(),C,toler, ktup)
定义SVM的一些参数,C,惩罚因子,toler,误差,ktup,选择核函数。
optStruct()函数入下:大部分大家应该都懂,就最后一个,就是核函数
class optStruct:
    def __init__(self,dataMatIn, classLabels, C, toler, kTup):  # Initialize the structure with the parameters
        self.X = dataMatIn
        self.labelMat = classLabels
        self.C = C# 200
        self.tol = toler  #toler为公差0.0001
        self.m = shape(dataMatIn)[0]#402
        self.alphas = mat(zeros((self.m,1)))
        self.b = 0
        self.eCache = mat(zeros((self.m,2))) #first column is valid flag
        self.K = mat(zeros((self.m,self.m)))
        for i in range(self.m):
            self.K[:,i] = kernelTrans(self.X, self.X[i,:], kTup)
kernelTrans()是自己定义的一个核函数计算公式,核函数作用很大,可以将不可分的低微数据向高维数据转化,变成可分的数据。
def kernelTrans(X, A, kTup): #calc the kernel or transform data to a higher dimensional space
    m,n = shape(X)  #402*1024
    K = mat(zeros((m,1)))
    # print(kTup)
    if kTup[0]=='lin':
        K = X * A.T   #linear kernel  X=402*1024  .*   A.T=1024*1       =402*1
    elif kTup[0]=='rbf':
        for j in range(m):
            deltaRow = X[j,:] - A
            # print( type(deltaRow),dot(deltaRow,deltaRow.T),(deltaRow*deltaRow.T))
            K[j] = dot(deltaRow,deltaRow.T)  #deltaRow*deltaRow.T 因为用了mat,所以这个和dot一样 1*1
        K = exp(K/(-1*kTup[1]**2)) #divide in NumPy is element-wise not matrix like Matlab  算出来其实K属于0-1,所以后边的有一步判断没必要
    else:
    	raise NameError('Houston We Have a Problem -- \
    That Kernel is not recognized')
    return K
因为我们选择的是rbf也就是径向基函数,def kernelTrans(X, A, kTup):中的A就是class optStruct:中传过去的 self.X[i,:]就是数据的第i行,
for j in range(m):
deltaRow = X[j,:] - A
# print( type(deltaRow),dot(deltaRow,deltaRow.T),(deltaRowdeltaRow.T))
K[j] = dot(deltaRow,deltaRow.T) #deltaRowdeltaRow.T 因为用了mat,所以这个和dot一样 11
K = exp(K/(-1kTup[1]**2))
上面程序就是用数据的第j行减去第i行作为核矩阵的第i行第j列的元素。注意,这里的第i行对于一次循环来说是固定的,因为每次循环只传递进去某一行,分别被各行相减。这里为什么相减呢?有些人就要问了?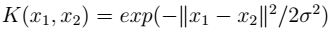
因为我们选用的是高斯核函数,又叫径向基函数。它的形式就是上面的那样。好了,下面我们重新讲smoP代码了
    iter = 0
    entireSet = True; alphaPairsChanged = 0
    while (iter < maxIter) and(   (alphaPairsChanged > 0) or(entireSet)  ):
什么时候进行循环学习呢?
(1):当迭代次数不超过最大迭代次数时。
(2):当没有必要迭代时(没有必要时就是alpha不在被修改了,也就是已经最优了,即alphaPairsChanged=0时)
那为什么while后边会有三个参数呢?(entireSet),因为没有它这个循环就不会开始想想是不是?iter < maxIter成立,但是alphaPairsChanged > 0不成立啊?所以entireSet出现了。
把代码再粘贴一下吧,太远了不好看
def smoP(dataMatIn, classLabels, C, toler, maxIter,ktup):    #full Platt SMO
    oS = optStruct(mat(dataMatIn),mat(classLabels).transpose(),C,toler, ktup)
    # print(oS.K.shape)402*402
    # for i in range(402):    K的对角线元素全为1
    # 	print(oS.K.A[i][i])
    iter = 0
    entireSet = True; alphaPairsChanged = 0
    while (iter < maxIter) and(   (alphaPairsChanged > 0) or(entireSet)  ):#一直执行这个循环,直到循环10000次或者alpha不再改变
        alphaPairsChanged = 0
        if entireSet:   #go over all

            for i in range(oS.m): #oS.m=402
                alphaPairsChanged += innerL(i,oS,iter)
                print ("fullSet, iter: %d i:%d, pairs changed %d" % (iter,i,alphaPairsChanged))
            iter += 1
        else:#go over non-bound (railed) alphas
            nonBoundIs = nonzero((oS.alphas.A > 0) * (oS.alphas.A < C))[0]#找到alpha中同时满足大于0小于c的数,[0]表示返回索引值
            for i in nonBoundIs:
                alphaPairsChanged += innerL(i,oS,iter)
                print ("non-bound, iter: %d i:%d, pairs changed %d" % (iter,i,alphaPairsChanged))
            iter += 1
        #下面这句自己加的,可以在训练达到最好时及时停止。因为上面的程序在偶数时不会停止
        if alphaPairsChanged==0:
        	maxIter=iter

        if entireSet:
            entireSet = False #toggle entire set loop
        elif (alphaPairsChanged == 0):
            entireSet = True
        print ("iteration number: %d" % iter)
    return oS.b,oS.alphas
alphaPairsChanged = 0进入循环第一件事就是置0.因为我们就是要看他有没有被修改的,所以每次置0,看他有没有改变,没改变就结束循环了。刚才一直说alpha被修改,学习,但是怎么学习和修改呢?
innerL函数就是学习的过程:
def innerL(i, oS,iter):
    Ei = calcEk(oS, i)
    if (((oS.labelMat[i]*Ei < -oS.tol) and (oS.alphas[i] < oS.C)) or(oS.labelMat[i]*Ei >oS.tol) and (oS.alphas[i] > 0)):
        j,Ej = selectJ(i, oS, Ei) #this has been changed from selectJrand
        # print(Ej,j)
        alphaIold = oS.alphas[i].copy(); alphaJold = oS.alphas[j].copy(); #list.copy复制了一个副本,对副本列表进行操作时,不会影响原列表,不用copy将会改变原列表
        if (oS.labelMat[i] != oS.labelMat[j]):
            L = max(0, oS.alphas[j] - oS.alphas[i])
            H = min(oS.C, oS.C + oS.alphas[j] - oS.alphas[i])
        else:
            L = max(0, oS.alphas[j] + oS.alphas[i] - oS.C)
            H = min(oS.C, oS.alphas[j] + oS.alphas[i])
        if L==H: #                                                                          smo算法原理 见刘建平讲解
        	print ("L==H");
        	return 0

        eta = -2.0 * oS.K[i,j] + oS.K[i,i] + oS.K[j,j] #changed for kernel  K对角线元素全为1
        if eta <= 0:
        	print ("eta<=0");#这一步判断应该是没必要,因为K属于0-1,kii=1,所以二塔恒大于0,除非kij为1
        	return 0#return 0之后就不再执行下面的程序了
        oS.alphas[j] += oS.labelMat[j]*(Ei - Ej)/eta
        oS.alphas[j] = clipAlpha(oS.alphas[j],H,L)
        updateEk(oS, j) #added this for the Ecache
        if (abs(oS.alphas[j] - alphaJold) < 0.00001):
            print ("j not moving enough");
            return 0 #return 0之后就不再执行下面的程序了   # 如果j变化不大,说明j移动不够,就不用更新i了,跳过这次
        oS.alphas[i] += oS.labelMat[j]*oS.labelMat[i]*(alphaJold - oS.alphas[j])#update i by the same amount as j
        updateEk(oS, i) #added this for the Ecache                    #the update is in the oppostie direction
        b1 = oS.b - Ei- oS.labelMat[i]*(oS.alphas[i]-alphaIold)*oS.K[i,i] - oS.labelMat[j]*(oS.alphas[j]-alphaJold)*oS.K[i,j]
        b2 = oS.b - Ej- oS.labelMat[i]*(oS.alphas[i]-alphaIold)*oS.K[i,j]- oS.labelMat[j]*(oS.alphas[j]-alphaJold)*oS.K[j,j]
        if (0 < oS.alphas[i]) and (oS.C > oS.alphas[i]):
        	oS.b = b1
        elif (0 < oS.alphas[j]) and (oS.C > oS.alphas[j]):
        	oS.b = b2
        else:
        	oS.b = (b1 + b2)/2.0
        return 1
    else:
    	return 0
大家都知道神经网络需要误差反向传播,用以网络的学习,那SVM也不例外,同样需要误差,才能学习,修改参数。
def calcEk(oS, k):
    fXk = float(multiply(oS.alphas,oS.labelMat).T*oS.K[:,k] + oS.b)
    #                     402*1.T.*402*1=1*1
    Ek = fXk - float(oS.labelMat[k])
    return Ek
关于上面文字推论很多,详细看我资源里面有一本SVM的书,很详细
以下是完整代码
'''
Created on Nov 4, 2010
Chapter 5 source file for Machine Learing in Action
@author: Peter
'''
from numpy import *
# from time import sleep

def loadDataSet(fileName):
    dataMat = []; labelMat = []
    fr = open(fileName)
    for line in fr.readlines():
        lineArr = line.split('\t')
        # print(type(line))
        dataMat.append([float(lineArr[0]), float(lineArr[1])])
        labelMat.append(float(lineArr[2]))
    # print(type(dataMat))
    return dataMat,labelMat

def selectJrand(i,m):
    j=i #we want to select any J not equal to i
    while (j==i):
        j = int(random.uniform(0,m))#只要i和j相等,就一直循环生成随机数,知道不相等,返回j
        # print(1)
    return j

def clipAlpha(aj,H,L):
    if aj > H:
        aj = H
    if L > aj:
        aj = L
    return aj

def smoSimple(dataMatIn, classLabels, C, toler, maxIter):#简化版SMO算法,序列最小优化(Sequential Minimal Optimization, SMO) 算法
    dataMatrix = mat(dataMatIn); labelMat = mat(classLabels).transpose()
    b = 0; m,n = shape(dataMatrix)
    alphas = mat(zeros((m,1)))
    iter = 0
    while (iter < maxIter):
        alphaPairsChanged = 0
        for i in range(m):
            fXi = float(multiply(alphas,labelMat).T*(dataMatrix*dataMatrix[i,:].T)) + b #这里的计算方式不一样
            # if labelMat[i]<0:
            # 	# print(fXi,labelMat[i])
            # 	if fXi>0:
            # 		print(fXi)
            	 #为什么标签为-1对应的fXi为负数,因为alpha>0,乘以负数还为负数。后边的数字均为正,故为负数。
            Ei = fXi - float(labelMat[i])#if checks if an example violates KKT conditions
            # if ((abs(fXi*labelMat[i]-1)>=toler) and (alphas[i] >= 0) and (alphas[i] <C)):#自己按照定义设置的

            # if (((Ei*labelMat[i]>=toler)) or(Ei*labelMat[i]<=-toler) ): # ((labelMat[i]*Ei < -toler) and (alphas[i] >= 0) ) or ((labelMat[i]*Ei > toler) and (alphas[i] <=C) )):
            if (((labelMat[i]*Ei < -toler) and (alphas[i] < C)) or(labelMat[i]*Ei >toler) and (alphas[i] > 0)):
                j = selectJrand(i,m)
                fXj = float(multiply(alphas,labelMat).T*(dataMatrix*dataMatrix[j,:].T)) + b
                Ej = fXj - float(labelMat[j])
                alphaIold = alphas[i].copy(); alphaJold = alphas[j].copy();
                if (labelMat[i] != labelMat[j]):
                    L = max(0, alphas[j] - alphas[i])
                    H = min(C, C + alphas[j] - alphas[i])
                else:
                    L = max(0, alphas[j] + alphas[i] - C)
                    H = min(C, alphas[j] + alphas[i])
                if L==H:
                    print ("L==H")
                    continue
                eta = 2.0 * dataMatrix[i,:]*dataMatrix[j,:].T - dataMatrix[i,:]*dataMatrix[i,:].T - dataMatrix[j,:]*dataMatrix[j,:].T
                if eta >= 0:
                	print ("eta>=0");
                	continue
                alphas[j] -= labelMat[j]*(Ei - Ej)/eta
                alphas[j] = clipAlpha(alphas[j],H,L)
                if (abs(alphas[j] - alphaJold) < 0.00001):
                	print ("j not moving enough");
                	continue
                alphas[i] += labelMat[j]*labelMat[i]*(alphaJold - alphas[j])#update i by the same amount as j
                                                                        #the update is in the oppostie direction
                b1 = b - Ei- labelMat[i]*(alphas[i]-alphaIold)*dataMatrix[i,:]*dataMatrix[i,:].T - labelMat[j]*(alphas[j]-alphaJold)*dataMatrix[i,:]*dataMatrix[j,:].T
                b2 = b - Ej- labelMat[i]*(alphas[i]-alphaIold)*dataMatrix[i,:]*dataMatrix[j,:].T - labelMat[j]*(alphas[j]-alphaJold)*dataMatrix[j,:]*dataMatrix[j,:].T
                if (0 < alphas[i]) and (C > alphas[i]):
                	b = b1
                elif (0 < alphas[j]) and (C > alphas[j]):
                	b = b2
                else:
                	b = (b1 + b2)/2.0
                alphaPairsChanged += 1
                print ("iter: %d i:%d, pairs changed %d" % (iter,i,alphaPairsChanged))
        # if (alphaPairsChanged == 0): maxIter =iter
        # else: iter += 1
        iter+=1
        print ("iteration number: %d" % iter)
    return b,alphas

def kernelTrans(X, A, kTup): #calc the kernel or transform data to a higher dimensional space
    m,n = shape(X)  #402*1024
    K = mat(zeros((m,1)))
    # print(kTup)
    if kTup[0]=='lin':
        K = X * A.T   #linear kernel  X=402*1024  .*   A.T=1024*1       =402*1
    elif kTup[0]=='rbf':
        for j in range(m):
            deltaRow = X[j,:] - A
            # print( type(deltaRow),dot(deltaRow,deltaRow.T),(deltaRow*deltaRow.T))
            K[j] = dot(deltaRow,deltaRow.T)  #deltaRow*deltaRow.T 因为用了mat,所以这个和dot一样 1*1
        K = exp(K/(-1*kTup[1]**2)) #divide in NumPy is element-wise not matrix like Matlab  算出来其实K属于0-1,所以后边的有一步判断没必要
    else:
    	raise NameError('Houston We Have a Problem -- \
    That Kernel is not recognized')
    return K

class optStruct:
    def __init__(self,dataMatIn, classLabels, C, toler, kTup):  # Initialize the structure with the parameters
        self.X = dataMatIn
        self.labelMat = classLabels
        self.C = C# 200
        self.tol = toler  #toler为公差0.0001
        self.m = shape(dataMatIn)[0]#402
        self.alphas = mat(zeros((self.m,1)))
        self.b = 0
        self.eCache = mat(zeros((self.m,2))) #first column is valid flag
        self.K = mat(zeros((self.m,self.m)))
        for i in range(self.m):
            self.K[:,i] = kernelTrans(self.X, self.X[i,:], kTup)


def calcEk(oS, k):
    fXk = float(multiply(oS.alphas,oS.labelMat).T*oS.K[:,k] + oS.b)
    #                     402*1.T.*402*1=1*1
    Ek = fXk - float(oS.labelMat[k])
    return Ek

def selectJ(i, oS, Ei):         #this is the second choice -heurstic, and calcs Ej
    maxK = -1; maxDeltaE = 0; Ej = 0
    oS.eCache[i] = [1,Ei]  #set valid #choose the alpha that gives the maximum delta E
    # print(oS.eCache[:,0])
    # print(maxK)
    validEcacheList = nonzero(oS.eCache[:,0])[0]
    # print(oS.eCache[:,0])   #numpy.nonzero函数是numpy中用于得到数组array中非零元素的位置(数组索引)的函数
    # print(len(validEcacheList))
    if (len(validEcacheList)) > 1:
        for k in validEcacheList:   #loop through valid Ecache values and find the one that maximizes delta E
            if k == i:
                continue #don't calc for i, waste of time    continue,跳出此次for循环
            #其实不用这个就行,因为后边加了判断语句取最大值,自动就把小的值剔除,试了一下,把上面的注释之后,对结果没影响
            Ek = calcEk(oS, k)
            deltaE = abs(Ei - Ek)
            if (deltaE > maxDeltaE):
                maxK = k; maxDeltaE = deltaE; Ej = Ek
        return maxK, Ej
    else:   #in this case (first time around) we don't have any valid eCache values
        j = selectJrand(i, oS.m)
        Ej = calcEk(oS, j)
    return j, Ej

def updateEk(oS, k):#after any alpha has changed update the new value in the cache
    Ek = calcEk(oS, k)
    oS.eCache[k] = [1,Ek]


def innerL(i, oS,iter):
    Ei = calcEk(oS, i)
    # print(oS.labelMat[i])
    # if ( (oS.alphas[i] < oS.C)) or ( (oS.alphas[i] > 0)):#下面条件可以简化成这样的格式。会对正确率造成百分之0.5的损失
    #下面的这个约束条件是说误差太小或者变化不大时,就不更新
    # if (((oS.labelMat[i]*Ei < -oS.tol)  or ((oS.labelMat[i]*Ei > oS.tol))) and((oS.alphas[i] >= 0) and(oS.alphas[i] < oS.C) )):
    if (((oS.labelMat[i]*Ei < -oS.tol) and (oS.alphas[i] < oS.C)) or(oS.labelMat[i]*Ei >oS.tol) and (oS.alphas[i] > 0)):
    	#上面的条件中,若包含alpha>=0则正确率会降低,因为alpha=0时位于边界
    # if (((oS.labelMat[i]*Ei >= -oS.tol) or (oS.alphas[i] < oS.C)) ):用or就是为了让循环能够顺利进行
#即使不要or后边的限制条件也可以,因为下面会随机选择一个j,也会选到一个alpha并改变它,计算反而更快。
        j,Ej = selectJ(i, oS, Ei) #this has been changed from selectJrand
        # print(Ej,j)
        alphaIold = oS.alphas[i].copy(); alphaJold = oS.alphas[j].copy(); #list.copy复制了一个副本,对副本列表进行操作时,不会影响原列表,不用copy将会改变原列表
        if (oS.labelMat[i] != oS.labelMat[j]):
            L = max(0, oS.alphas[j] - oS.alphas[i])
            H = min(oS.C, oS.C + oS.alphas[j] - oS.alphas[i])
        else:
            L = max(0, oS.alphas[j] + oS.alphas[i] - oS.C)
            H = min(oS.C, oS.alphas[j] + oS.alphas[i])
        if L==H: #                                                                          smo算法原理 见刘建平讲解
        	print ("L==H");
        	return 0

        eta = -2.0 * oS.K[i,j] + oS.K[i,i] + oS.K[j,j] #changed for kernel  K对角线元素全为1
        if eta <= 0:
        	print ("eta<=0");#这一步判断应该是没必要,因为K属于0-1,kii=1,所以二塔恒大于0,除非kij为1
        	return 0#return 0之后就不再执行下面的程序了
        oS.alphas[j] += oS.labelMat[j]*(Ei - Ej)/eta
        oS.alphas[j] = clipAlpha(oS.alphas[j],H,L)
        updateEk(oS, j) #added this for the Ecache
        if (abs(oS.alphas[j] - alphaJold) < 0.00001):
            print ("j not moving enough");
            return 0 #return 0之后就不再执行下面的程序了   # 如果j变化不大,说明j移动不够,就不用更新i了,跳过这次
        oS.alphas[i] += oS.labelMat[j]*oS.labelMat[i]*(alphaJold - oS.alphas[j])#update i by the same amount as j
        updateEk(oS, i) #added this for the Ecache                    #the update is in the oppostie direction
        b1 = oS.b - Ei- oS.labelMat[i]*(oS.alphas[i]-alphaIold)*oS.K[i,i] - oS.labelMat[j]*(oS.alphas[j]-alphaJold)*oS.K[i,j]
        b2 = oS.b - Ej- oS.labelMat[i]*(oS.alphas[i]-alphaIold)*oS.K[i,j]- oS.labelMat[j]*(oS.alphas[j]-alphaJold)*oS.K[j,j]
        if (0 < oS.alphas[i]) and (oS.C > oS.alphas[i]):
        	oS.b = b1
        elif (0 < oS.alphas[j]) and (oS.C > oS.alphas[j]):
        	oS.b = b2
        else:
        	oS.b = (b1 + b2)/2.0
        return 1
    else:
    	return 0

def smoP(dataMatIn, classLabels, C, toler, maxIter,ktup):    #full Platt SMO
    oS = optStruct(mat(dataMatIn),mat(classLabels).transpose(),C,toler, ktup)
    # print(oS.K.shape)402*402
    # for i in range(402):    K的对角线元素全为1
    # 	print(oS.K.A[i][i])
    iter = 0
    entireSet = True; alphaPairsChanged = 0
    while (iter < maxIter) and(   (alphaPairsChanged > 0) or(entireSet)  ):#一直执行这个循环,直到循环10000次或者alpha不再改变
        alphaPairsChanged = 0
        if entireSet:   #go over all
            # print(3213213333333333333333333333333333)
            for i in range(oS.m): #oS.m=402
                alphaPairsChanged += innerL(i,oS,iter)
                print ("fullSet, iter: %d i:%d, pairs changed %d" % (iter,i,alphaPairsChanged))
            iter += 1
        else:#go over non-bound (railed) alphas
            nonBoundIs = nonzero((oS.alphas.A > 0) * (oS.alphas.A < C))[0]#找到alpha中同时满足大于0小于c的数,[0]表示返回索引值
            for i in nonBoundIs:
                alphaPairsChanged += innerL(i,oS,iter)
                print ("non-bound, iter: %d i:%d, pairs changed %d" % (iter,i,alphaPairsChanged))
            iter += 1
        #下面这句自己加的,可以在训练达到最好时及时停止。因为上面的程序在偶数时不会停止
        if alphaPairsChanged==0:
        	maxIter=iter

        if entireSet:
            entireSet = False #toggle entire set loop
        elif (alphaPairsChanged == 0):
            entireSet = True
        print ("iteration number: %d" % iter)
    return oS.b,oS.alphas

def calcWs(alphas,dataArr,classLabels):
    X = mat(dataArr); labelMat = mat(classLabels).transpose()
    m,n = shape(X)
    w = zeros((n,1))
    for i in range(m):
        w += multiply(alphas[i]*labelMat[i],X[i,:].T)
    return w

def testRbf(k1=1.3):
    dataArr,labelArr = loadDataSet('testSetRBF.txt')
    b,alphas = smoP(dataArr, labelArr, 200, 0.0001, 10000, ('rbf', k1)) #C=200 important
    datMat=mat(dataArr); labelMat = mat(labelArr).transpose()
    svInd=nonzero(alphas.A>0)[0]
    sVs=datMat[svInd] #get matrix of only support vectors
    labelSV = labelMat[svInd];
    print ("there are %d Support Vectors" % shape(sVs)[0])
    m,n = shape(datMat)
    errorCount = 0
    for i in range(m):
        kernelEval = kernelTrans(sVs,datMat[i,:],('rbf', k1))
        predict=kernelEval.T * multiply(labelSV,alphas[svInd]) + b
        if sign(predict)!=sign(labelArr[i]): errorCount += 1
    print ("the training error rate is: %f" % (float(errorCount)/m))
    dataArr,labelArr = loadDataSet('testSetRBF2.txt')
    errorCount = 0
    datMat=mat(dataArr); labelMat = mat(labelArr).transpose()
    m,n = shape(datMat)
    for i in range(m):
        kernelEval = kernelTrans(sVs,datMat[i,:],('rbf', k1))
        predict=kernelEval.T * multiply(labelSV,alphas[svInd]) + b
        if sign(predict)!=sign(labelArr[i]): errorCount += 1
    print ("the test error rate is: %f" % (float(errorCount)/m))

def img2vector(filename):
    returnVect = zeros((1,1024))
    fr = open(filename)
    for i in range(32):
        lineStr = fr.readline()
        for j in range(32):
            returnVect[0,32*i+j] = int(lineStr[j])
    return returnVect

def loadImages(dirName):
    from os import listdir
    hwLabels = []
    trainingFileList = listdir(dirName)
    print(trainingFileList)          #load the training set
    m = len(trainingFileList)
    trainingMat = zeros((m,1024))#m=402
    # print(m)
    for i in range(m):
        fileNameStr = trainingFileList[i]
        # print(fileNameStr)
        fileStr = fileNameStr.split('.')[0]     #take off .txt
        classNumStr = int(fileStr.split('_')[0])
        if classNumStr == 9:
        	hwLabels.append(-1)
        else:
        	hwLabels.append(1)
        trainingMat[i,:] = img2vector('%s/%s' % (dirName, fileNameStr))
    # print(hwLabels)
    return trainingMat, hwLabels     # trainingMat  402*1024

def testDigits(kTup=('rbf', 10)):
    dataArr,labelArr = loadImages(r'C:\Users\Administrator\Desktop\MLiA_SourceCode\Ch06\digits\trainingDigits')
    b,alphas = smoP(dataArr, labelArr, 200, 0.0001, 10000,kTup)#加速版smo,训练时间短,正确率高
    # b,alphas = smoSimple(dataArr, labelArr, 200, 0.0001, 20)      #简化版smo,训练时间长,正确率不高
    # b,alphas = smoPK(dataArr, labelArr, 200, 0.0001, 10000)  #不用核函数的计算,与加速版的SMO算法区别仅在于不同的误差计算方法,即一个用了核函数,一个没用
    datMat=mat(dataArr); labelMat = mat(labelArr).transpose()  #dataArr,labelArr  402*1024  1*402
    svInd=nonzero(alphas>0)[0]
    # print(nonzero(alphas))
    # print(type(svInd))
    sVs=datMat[svInd] #支持向量
    labelSV = labelMat[svInd];
    print ("there are %d Support Vectors" % shape(sVs)[0])
    m,n = shape(datMat)#402*1024
    errorCount = 0
    for i in range(m):
        kernelEval = kernelTrans(sVs,datMat[i,:],kTup)
        predict=kernelEval.T * multiply(labelSV,alphas[svInd]) + b
        if sign(predict)!=(labelArr[i]):   #sign()的用法:大于0的返回1 # sign(2) = 1  小于0的返回-1 # sign(-3) = -1等于0的返回0 # sign(0) = 0
        	errorCount += 1
    print ("the training error rate is: %f" % (float(errorCount)/m))
    dataArr,labelArr = loadImages(r'C:\Users\Administrator\Desktop\MLiA_SourceCode\Ch06\digits\testDigits')
    errorCount = 0
    datMat=mat(dataArr); labelMat = mat(labelArr).transpose()
    m,n = shape(datMat)
    for i in range(m):
        kernelEval = kernelTrans(sVs,datMat[i,:],kTup)
        predict=kernelEval.T * multiply(labelSV,alphas[svInd]) + b
        if sign(predict)!=sign(labelArr[i]):
        	errorCount += 1
    print ("the test error rate is: %f" % (float(errorCount)/m))


'''#######********************************
Non-Kernel VErsions below   以下是不用核函数
'''#######********************************

class optStructK:
    def __init__(self,dataMatIn, classLabels, C, toler):  # Initialize the structure with the parameters
        self.X = dataMatIn
        self.labelMat = classLabels
        self.C = C
        self.tol = toler
        self.m = shape(dataMatIn)[0]
        self.alphas = mat(zeros((self.m,1)))
        self.b = 0
        self.eCache = mat(zeros((self.m,2))) #first column is valid flag

def calcEkK(oS, k):
    fXk = float(multiply(oS.alphas,oS.labelMat).T*(oS.X*oS.X[k,:].T)) + oS.b
    Ek = fXk - float(oS.labelMat[k])
    return Ek

def selectJK(i, oS, Ei):         #this is the second choice -heurstic, and calcs Ej
    maxK = -1; maxDeltaE = 0; Ej = 0
    oS.eCache[i] = [1,Ei]  #set valid #choose the alpha that gives the maximum delta E
    validEcacheList = nonzero(oS.eCache[:,0])[0]
    if (len(validEcacheList)) > 1:
        for k in validEcacheList:   #loop through valid Ecache values and find the one that maximizes delta E
            if k == i: continue #don't calc for i, waste of time
            Ek = calcEkK(oS, k)
            deltaE = abs(Ei - Ek)
            if (deltaE > maxDeltaE):
                maxK = k; maxDeltaE = deltaE; Ej = Ek
        return maxK, Ej
    else:   #in this case (first time around) we don't have any valid eCache values
        j = selectJrand(i, oS.m)
        Ej = calcEkK(oS, j)
    return j, Ej

def updateEkK(oS, k):#after any alpha has changed update the new value in the cache
    Ek = calcEkK(oS, k)
    oS.eCache[k] = [1,Ek]

def innerLK(i, oS):
    Ei = calcEkK(oS, i)
    if ((oS.labelMat[i]*Ei < -oS.tol) and (oS.alphas[i] < oS.C)) or ((oS.labelMat[i]*Ei > oS.tol) and (oS.alphas[i] > 0)):
        j,Ej = selectJK(i, oS, Ei) #this has been changed from selectJrand
        alphaIold = oS.alphas[i].copy(); alphaJold = oS.alphas[j].copy();
        if (oS.labelMat[i] != oS.labelMat[j]):
            L = max(0, oS.alphas[j] - oS.alphas[i])
            H = min(oS.C, oS.C + oS.alphas[j] - oS.alphas[i])
        else:
            L = max(0, oS.alphas[j] + oS.alphas[i] - oS.C)
            H = min(oS.C, oS.alphas[j] + oS.alphas[i])
        if L==H:
        	print ("L==H");
        	return 0
        eta = -2.0 * oS.X[i,:]*oS.X[j,:].T + oS.X[i,:]*oS.X[i,:].T + oS.X[j,:]*oS.X[j,:].T
        if -eta >= 0:
        	print ("-eta>=0");
        	return 0
        oS.alphas[j] += oS.labelMat[j]*(Ei - Ej)/eta
        oS.alphas[j] = clipAlpha(oS.alphas[j],H,L)
        updateEkK(oS, j) #added this for the Ecache
        if (abs(oS.alphas[j] - alphaJold) < 0.00001):
        	print ("j not moving enough");
        	return 0
        oS.alphas[i] += oS.labelMat[j]*oS.labelMat[i]*(alphaJold - oS.alphas[j])#update i by the same amount as j
        updateEkK(oS, i) #added this for the Ecache                    #the update is in the oppostie direction
        b1 = oS.b - Ei- oS.labelMat[i]*(oS.alphas[i]-alphaIold)*oS.X[i,:]*oS.X[i,:].T - oS.labelMat[j]*(oS.alphas[j]-alphaJold)*oS.X[i,:]*oS.X[j,:].T
        b2 = oS.b - Ej- oS.labelMat[i]*(oS.alphas[i]-alphaIold)*oS.X[i,:]*oS.X[j,:].T - oS.labelMat[j]*(oS.alphas[j]-alphaJold)*oS.X[j,:]*oS.X[j,:].T
        if (0 < oS.alphas[i]) and (oS.C > oS.alphas[i]):
        	oS.b = b1
        elif (0 < oS.alphas[j]) and (oS.C > oS.alphas[j]):
        	oS.b = b2
        else:
        	oS.b = (b1 + b2)/2.0
        return 1
    else: return 0

def smoPK(dataMatIn, classLabels, C, toler, maxIter):    #full Platt SMO
    oS = optStructK(mat(dataMatIn),mat(classLabels).transpose(),C,toler)
    iter = 0
    entireSet = True; alphaPairsChanged = 0
    while (iter < maxIter) and ((alphaPairsChanged > 0) or (entireSet)):
        alphaPairsChanged = 0
        if entireSet:   #go over all
            for i in range(oS.m):
                alphaPairsChanged += innerLK(i,oS)
                print ("fullSet, iter: %d i:%d, pairs changed %d" % (iter,i,alphaPairsChanged))
            iter += 1
        else:#go over non-bound (railed) alphas
            nonBoundIs = nonzero((oS.alphas.A > 0) * (oS.alphas.A < C))[0]
            for i in nonBoundIs:
                alphaPairsChanged += innerLK(i,oS)
                print ("non-bound, iter: %d i:%d, pairs changed %d" % (iter,i,alphaPairsChanged))
            iter += 1
        if alphaPairsChanged==0:
            maxIter=iter
        if entireSet:
            entireSet = False #toggle entire set loop
        elif (alphaPairsChanged == 0):
        	entireSet = True
        print ("iteration number: %d" % iter)
    return oS.b,oS.alphas
# testRbf()
testDigits()
CSDN联合极客时间,共同打造面向开发者的精品内容学习社区,助力成长!
更多推荐
 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)