模式识别阅读笔记(一):绪论(1)
文章目录
模式识别解决的问题
- 关注利用计算机算法自动发现数据中的规律, 以及使用这些规律采取将数据分类等行动
基本名词
例子:识别手写数字。每个数字对应 28 × 28 28 \times28 28×28像素的图像,那么我们将其表示为一共 784 784 784个像素组成的向量 x x x, 目标是建立一个机器,使得以 x x x为输出,以 y ∈ { 0 . . 9 } y \in \{0_{..}9\} y∈{0..9} 作为输出。
- 训练集: X t r a i n = { x 1 , x 2 , . . . , x n } X_{train} = \{x_1, x_2, ..., x_n\} Xtrain={x1,x2,...,xn}。
- 测试集: X t e s t = { x 2 , x 2 , . . . , x m } , X t e s t ⋂ X t r a i n = ∅ X_{test} = \{x_2, x_2, ..., x_m\}, X_{test} \bigcap X_{train} = \emptyset Xtest={x2,x2,...,xm},Xtest⋂Xtrain=∅ 。
- 泛化(generalization):正确分类与训练集数据不同数据的能力。
- 预处理(pre-processed):有时也叫特征抽取。例如对图片的缩放、旋转。
学习分类
- 监督学习(supervised learning):训练样本包括输入向量
x
x
x 以及输出向量
y
y
y
- 分类(classification): y y y是离散的,比如数字识别
- 回归(regression): y y y是连续的,比如预测房价
- 无监督学习(unsupervised learning): 训练样本仅包括输入向量
x
x
x
- 聚类(clustering):发现相似样本的分组。
- 密度估计(density estimation):求得输入空间中数据的分布。
- 反馈学习(reinforcement learning): 关注在确定条件,找到合适动作,使奖励最大。并且,没有给出 最优输出(最好的一系列动作)。比如围棋博弈之类的问题。
- 探索(exploration):反馈学习尝试新类型动作。
- 利用(exploitation): 反馈学习使用已知能够产生高奖励的动作。
- 折中:反馈学习不可仅仅过分专注于探索或者利用。
例子:多项式曲线拟合
数据的产生
-
例子的数据由函数 s i n ( 2 π x ) sin(2\pi x) sin(2πx)产生, x x x的生成服从 0 − 1 0-1 0−1的均匀分布,并且加上了满足标准差为 σ = 0.3 \sigma=0.3 σ=0.3的高斯分布的噪音。
-
对此解释一下加上噪音这一点的。首先我们要理解什么是概率分布, 概率分布表征了 随机变量 取值的概率规律。个人感觉概率分布是对随机变量的进一步抽象。因此,加上高斯分布的噪音,直观上理解的就是,如果取样点很多,我们将横轴作为取样点与精确值偏差的具体数值(即噪音),纵轴作为对应噪音出现的频率,那么最后的图像就是高斯分布的图像。
例子数据与真实数据的共有性质。——纯粹的个人理解
- 首先我们要理解,现实生活中的数据应该具有两个属性,一个是真实值,一个是观测值。我们能够接触到的,只能是观测值,真实值是不可知的(突然想起以前看过的哲学了…)。观测值和真实值间有着一定的偏差, 偏差的产生来自于噪音源产生的噪音。数据真实值的集合有一个内在的规律,这个规律表现为一定的分布。噪声源可以是可知的,也可以是不可知的。噪声源产生的噪音可能是随机的,也可能满足一定的分布,即有一定内在规律。
- 因此在这个例子中, s i n ( 2 π x ) sin(2 \pi x) sin(2πx)这个函数表示了真实数据的一种规律(即一种分布)。每一个点对应一个数据, s i n ( 2 π x ) sin(2\pi x) sin(2πx)对于真实值,而图中实际点的位置 t t t的值即为观测值。因为噪音是人为模拟的,因此噪声源可以看作人,人产生的噪音满足高斯分布,即 t − s i n ( 2 π x ) t-sin(2\pi x) t−sin(2πx)。
例子数据和真实数据元素对应关系
| 例子中数据元素 | 真实数据元素 |
|---|---|
| 图中的点 | 真实数据 |
| f ( x ) = s i n ( 2 π x ) f(x)=sin(2 \pi x) f(x)=sin(2πx) | 数据内在规律 |
| s i n ( 2 π x sin(2\pi x sin(2πx) | 真实值 |
| 每一个数据 t t t值 | 观测值 |
| 人 | 噪音源 |
| t − s i n ( 2 π x t - sin(2\pi x t−sin(2πx) | 噪音 |
| 高斯分布 | 噪音源的内在规律 |
规律的学习
我们已经说过了模式识别是为了用计算机发现数据中的规律,然后运用,因此我们产生了数据后,现在就要学习这些数据的规律,这样的规律通常用函数来建模。这个例子中,我们采用多项式函数来拟合数据,表示规律,特别的,有些地方也说一个函数也就代表了一个模型,机器学习的过程实际上就是学一个函数。
多项式函数
- 考虑函数:
y ( x , w ) = w 0 + w 1 x + w M x M = ∑ j = 0 M w j x j y(x,w) = w_0 + w_1x+w_Mx^M = \sum_{j=0}^M w_jx^j y(x,w)=w0+w1x+wMxM=j=0∑Mwjxj - M:多项式阶数
- 注意 y ( x , w ) y(x,w) y(x,w)是关于 w w w的线性函数。且 y ( x , w ) y(x,w) y(x,w)由 w w w和 M M M确定,现在我们任务就转变为了确定 w w w和 M M M。那要怎么去确定呢,这就需要训练了,因此现在我们就是如何根据训练集来选择 M M M以及得到对应的 w w w。
误差函数
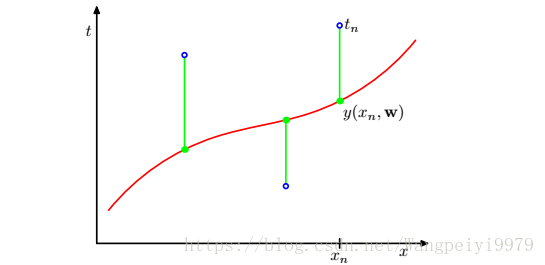
- 怎样根据数据拟合一个函数呢,这需要一个标准,这里书中提出了差的平方和函数。差值如图中绿色线所示。而我们通过最小化
E
(
w
)
E(w)
E(w)来拟合函数。
E ( w ) = 1 2 ∑ 1 N { y ( x n , w ) − t n } 2 E(w) = \frac{1}{2} \sum_1^N\{y(x_n,w)-t_n\}^2 E(w)=211∑N{y(xn,w)−tn}2
-
E
(
w
)
E(w)
E(w)的性质:
- 导数是关于 w w w的线性函数,因此误差函数的最小值只有一个唯一解。记作 w ∗ w^* w∗
-
M
M
M太小,会产生欠拟合的问题,而
M
M
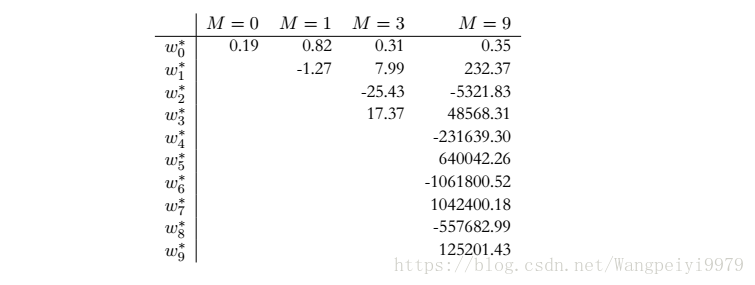
M过大,会产生过拟合的问题。过拟合的表现在哪里呢?书中给出了,当随着
M
M
M变大,参数
w
w
w会变得特别大,因此函数会震荡得很厉害。书中另一种理解是当
M
M
M值太大,函数过分注重了噪音。
- 当训练数据增多时,可以客服过拟合的问题。我的理解是,将拟合过程看成真实数据分布和噪音分布的对抗,数据多了,真实数据分布就越明显,换句话说,真实分布变强了,而噪音的分布没有变强,所以函数就能够更加拟合真实分布。
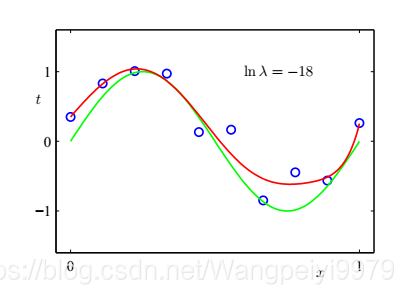
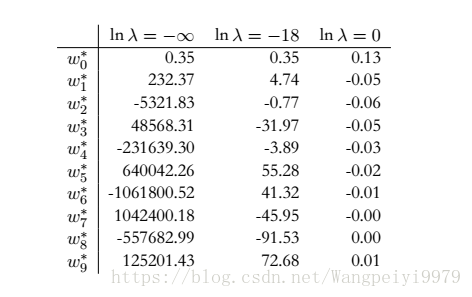
- 当然也可以通过正则来防止过拟合, 此时误差函数如下:
E ( w ) = 1 2 ∑ 1 N { y ( x n , w ) − t n } 2 + λ 2 ∣ ∣ w ∣ ∣ 2 E(w) = \frac{1}{2} \sum_1^N\{y(x_n,w)-t_n\}^2 + \frac{\lambda}{2}||w||^2 E(w)=211∑N{y(xn,w)−tn}2+2λ∣∣w∣∣2
上面提到,过拟合可能的原因是由于 w w w过大,所以通过后面的正则项,我们可以将 w w w的值变小。从而防止过拟合。
概率论基础
模式识别领域有很大的不确定性,这是由于噪音产生的。而概率论可以对这些不确定性进行量化和计算。因此对模式识别有重要的作用。
基本概念
例子:现在有两个随机变量 X , Y X,Y X,Y, 取值为 { x i } ⊆ { 1 , 2 , 3 , 4 , 5 } , { y i } ⊆ { 1 , 2 , 3 } \{x_i\} \subseteq \{1,2,3,4,5\}, \{y_i\} \subseteq \{1,2,3\} {xi}⊆{1,2,3,4,5},{yi}⊆{1,2,3}.现在考虑 N N N次试验,对 X , Y X,Y X,Y分别取样,将 X = x i 且 Y = y j X = x_i且 Y=y_j X=xi且Y=yj的次数记为 n i j n_{ij} nij, 将 X = x i X=x_i X=xi的次数记为 c i c_i ci,将 Y = y j Y=y_j Y=yj的次数 记为 r j r_j rj。这样我们有如下定义
- P ( X = x i ) = c j N P(X = x_i) = \frac{c_j}{N} P(X=xi)=Ncj
- 边缘概率: P ( X ) = ∑ Y p ( X , Y ) P(X) = \sum_Yp(X,Y) P(X)=∑Yp(X,Y) 加和规则
- 条件概率: P ( Y = y j ∣ X = x i ) = n i j c i P(Y=y_j|X=x_i) = \frac{n_{ij}}{c_i} P(Y=yj∣X=xi)=cinij
- 联合概率: P ( X , Y ) = p ( Y ∣ X ) p ( X ) P(X, Y) = p(Y|X)p(X) P(X,Y)=p(Y∣X)p(X) 乘积规则
贝叶斯公式
p
(
Y
∣
X
)
=
p
(
X
∣
Y
)
p
(
Y
)
∑
Y
p
(
X
∣
Y
)
p
(
Y
)
p(Y|X) =\frac{p(X|Y)p(Y)}{\sum_Yp(X|Y)p(Y)}
p(Y∣X)=∑Yp(X∣Y)p(Y)p(X∣Y)p(Y)
此公式在模式识别和机器学习领域扮演中心角色。因为其可以由果溯因。
概率密度
考虑了离散取值后,我们也会遇到连续取值的情况。如果一个实值变量
X
X
X落在区间
(
x
,
x
+
δ
x
)
(x, x+\delta x)
(x,x+δx)的概率定义为
p
(
x
)
δ
x
,
δ
x
→
0
p(x)\delta x, \delta x \to 0
p(x)δx,δx→0。那么
p
(
x
)
p(x)
p(x)叫做
x
x
x的概率密度。
x
x
x位于区间
(
a
,
b
)
(a,b)
(a,b)的概率由由下式给出
p
(
x
∈
(
a
,
b
)
)
=
∫
a
b
p
(
x
)
d
x
p(x \in (a,b)) = \int_a^bp(x) {d}x
p(x∈(a,b))=∫abp(x)dx
- 若有变换 x = g ( y ) x = g(y) x=g(y), 那么将 x x x变换到 y y y的空间,有 p ( y ) δ y ≈ p ( x ) δ x p(y) \delta y \approx p(x) \delta x p(y)δy≈p(x)δx,则 p ( y ) ≈ p ( x ) δ x δ y = p ( x ) g ′ ( y ) p(y) \approx p(x)\frac{\delta x}{\delta y} = p(x)g'(y) p(y)≈p(x)δyδx=p(x)g′(y)
- 同样有积分形式的加和规则和乘积规则。
期望和协方差
期望定义:在概率分布 p ( x ) p(x) p(x)下,函数 f ( x ) f(x) f(x)的平均值成为 f ( x ) f(x) f(x)的期望,记做 E [ f ] {\rm E}[f] E[f],
- 对离散变量: E [ f ] = ∑ x p ( x ) f ( x ) {\rm E}[f] = \sum_xp(x)f(x) E[f]=∑xp(x)f(x)
- 对连续变量: E [ f ] = ∫ p ( x ) f ( x ) d x {\rm E}[f] = \int p(x)f(x) {\rm d}x E[f]=∫p(x)f(x)dx
- 对条件分布: E x [ f ∣ y ] = ∑ x p ( x ∣ y ) f ( x ) {\rm E}_x[f | y] = \sum_xp(x|y)f(x) Ex[f∣y]=∑xp(x∣y)f(x)
方差定义:在均值
E
[
f
]
{\rm E}[f]
E[f]附近变化性的大小。
v
a
r
[
f
]
=
E
[
(
f
(
x
)
−
E
[
f
(
x
)
]
)
2
]
=
E
[
f
(
x
)
2
]
−
E
[
f
(
x
)
]
2
{\rm var}[f] = {\rm E}[(f(x) - {\rm E}[f(x)])^2] = {\rm E}[f(x)^2]- {\rm E}[f(x)]^2
var[f]=E[(f(x)−E[f(x)])2]=E[f(x)2]−E[f(x)]2
协方差定义:度量了多大程度上
x
和
y
x和y
x和y会共同变化,记做
c
o
v
[
x
,
y
]
cov[x,y]
cov[x,y]
c
o
v
[
x
,
y
]
=
E
x
,
y
[
x
y
T
]
−
E
[
x
]
E
[
y
T
]
cov[x,y] = {\rm E}_{x,y}[xy^T] - {\rm E}[x]E[y^T]
cov[x,y]=Ex,y[xyT]−E[x]E[yT]。
贝叶斯概率观点
我们知道,模式识别就是确定参数的过程。贝叶斯概率观点使用贝叶斯公式对这个过程进行了建模。现在有模型参数
w
w
w,观测数据
D
=
{
t
1
,
.
.
.
,
t
n
}
D = \{t_1, ..., t_n\}
D={t1,...,tn},贝叶斯观点建模有
p
(
w
∣
D
)
=
p
(
D
∣
w
)
p
(
w
)
p
(
D
)
p(w|D) = \frac{p(D|w)p(w)}{p(D)}
p(w∣D)=p(D)p(D∣w)p(w)
- 其中 p ( w ) p(w) p(w)为参数的先验概率, P ( w ∣ D ) P(w|D) P(w∣D)为观测到数据后, w w w的后验概率, P ( D ∣ w ) P(D|w) P(D∣w)为似然函数,似然函数表示了在不同 w w w下,观测数据出现的概率大小。
- 两边看做关于
w
w
w的函数,对
w
w
w求积分,由于左侧是关于
w
w
w的概率,因此为1,所以有:
p ( D ) = ∫ p ( D ∣ w ) p ( w ) d w p(D) = \int p(D | w) p(w) {\rm d}w p(D)=∫p(D∣w)p(w)dw p ( w ∣ D ) = p ( D ∣ w ) p ( w ) ∫ p ( D ∣ w ) p ( w ) d w p(w|D) = \frac{p(D|w)p(w)}{\int p(D | w) p(w) {\rm d}w} p(w∣D)=∫p(D∣w)p(w)dwp(D∣w)p(w) - 最终贝叶斯概率观点就是要选取使得后验概率最大的 w w w。
- 用形式语言表述贝叶斯定理 p o s t e r i o r ∝ l i k e l i h o o d × p r i o r posterior\propto likelihood \times prior posterior∝likelihood×prior
传统观点
而对于传统, 最终的目标是要求使得似然函数最大化的 w w w。
两种观点的比较
观察公式,两种观点本质性的区别就是是否引入了先验概率。若先验概率引入对了,那么贝叶斯方法就好于传统观点。若错了,则反之。而本书强调贝叶斯观点。
总结
这一节中,我们明确了模式识别的目标是什么,并且用一个例子来阐述了一些概念,还介绍了简单的概率论的知识,也初步了解了传统观点和贝叶斯观点的区别。在下一节,我们将会介绍几种典型的概率分布
CSDN联合极客时间,共同打造面向开发者的精品内容学习社区,助力成长!
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)